AI 資料飛輪:企業如何把營運資料轉成長期競爭優勢?
· AmberM
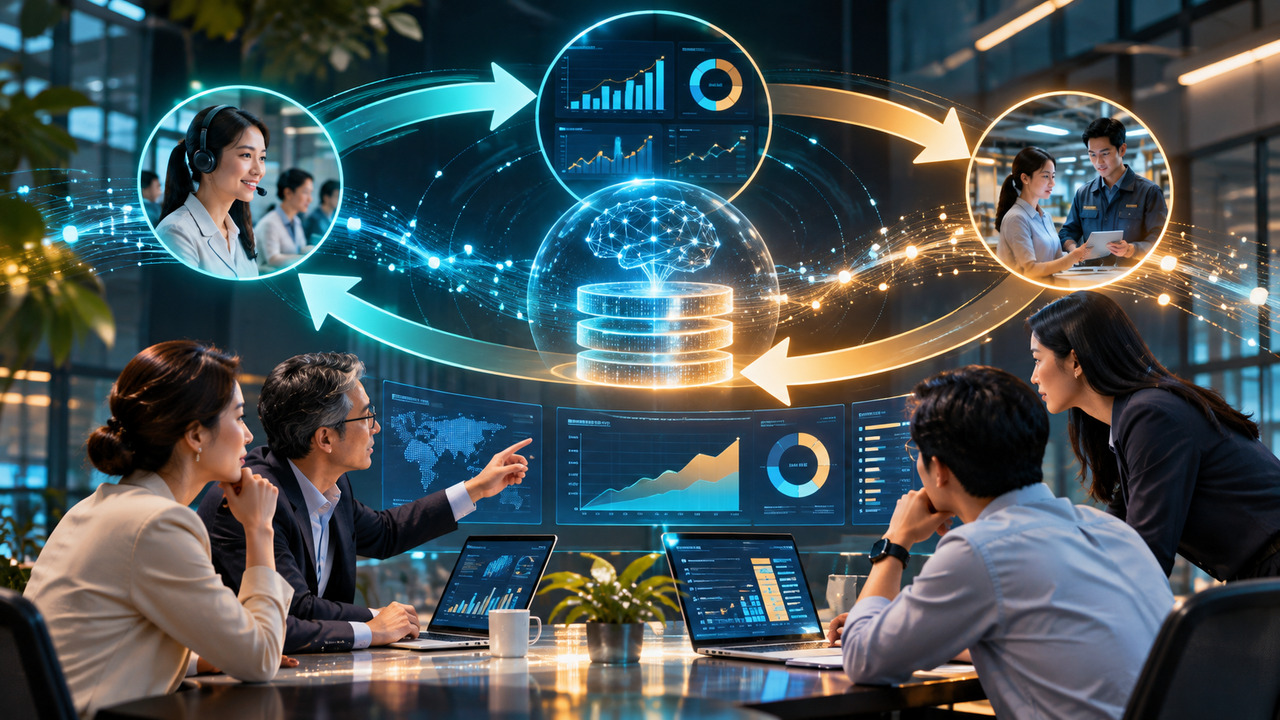
模型能力持續普及,企業是否只要採購同一套工具,就能取得相同成果?答案通常是否定的。真正拉開差距的,可能是企業如何把每天發生的交易、服務與作業經驗,轉化為下一次更好的判斷。這是一種以合法且高品質資料為基礎、能持續學習的營運機制。
從「資料很多」到「資料有用」,中間還缺三件事
不少企業擁有 CRM、ERP、客服紀錄與設備資料,卻難以讓跨部門用同一套定義討論問題。資料量不是資產價值的充分條件;來源可追溯、欄位可比較,以及與經營決策相關,才有機會產生價值。
經營團隊應先選一個成本或收入影響明確的問題,例如客訴重複發生、設備異常或訂單延誤,再盤點需要哪些資料、目前品質如何、誰負責修正。不要一開始就追求全公司的資料湖。
讓資料飛輪有清楚的起點與終點
一個可運作的飛輪至少包含四步:蒐集必要資料、透過規則或模型找出訊號、讓員工在真實工作流程中採用建議、再蒐集結果作為改善依據。若模型只產出漂亮儀表板,沒有改變工作決策,就只是資料展示。
例如售後維修團隊可將故障類型、處理方式與實際修復時間建立一致紀錄。下一次系統提出建議時,工程師仍負責確認;完成案件後留下結果,才能逐漸提升知識的可用性。
專有資料不等於可以無限制使用
企業資料可能包含個人資訊、客戶合約內容、機密製程及供應商資訊。資料能否用於訓練、外部模型服務或跨企業共享,必須依權限、契約與適用法規判斷。資料治理是飛輪的底座,而不是系統完成後才補做的文件。
建議先指定資料擁有者,整理分類分級、保留期限、存取紀錄與模型輸出審查程序。敏感資訊應優先評估去識別化、權限隔離與最小必要原則,而不是將全部資料直接匯入工具。
把領域專家放進學習循環
同一筆資料在不同產業有不同意義。機器設備的異常訊號、醫療工作流程的例外或客戶信用風險,不是純粹由語言模型就能判斷。真正寶貴的是現場人員如何定義標籤、處理例外與回饋結果。
企業應讓資訊、業務或作業單位共同決定「正確答案」如何界定,避免指標只對 IT 團隊有意義。模型的建議若與現場經驗衝突,要能記錄原因並追溯修正,而非盲目要求員工服從。
從三項指標判斷投資是否值得
第一是資料可用率:必要欄位是否完整且一致;第二是流程採用率:多少有效決策真的使用了資料或模型建議;第三是營運成果:重工、服務時間、損耗或留存等是否改善。三項指標要同時看,才不會把模型使用次數誤認為業績。
評估效益時應扣除資料清理、維運、人工審查及教育訓練成本。沒有基準期間與對照方法,任何「效益提升」都應先標示為初步觀察。
90 天啟動方案
前 30 天選定一項高頻決策,完成資料來源、權限與品質盤點;第 31 至 60 天建立小規模工作流程與人工審核機制;第 61 至 90 天檢視採用率、錯誤類型與營運結果,決定是否擴大。
真正值得投資的不是一套永不出錯的模型,而是一個可以不斷發現錯誤、修正流程並保留學習成果的組織。
結語
AI 的門檻可能愈來愈低,但把資料轉成決策、再把決策回饋成知識的能力,仍需要長期累積。企業的資料飛輪,不是從採購模型開始,而是從每一次可驗證的營運改善開始。
原始參考:AI 時代真正的護城河,可能不是模型,而是「你的資料飛輪」;本文依 E Fund Group 讀者需求實質改寫,非直接轉貼。
發佈留言